Beitrag vom 15. Oktober 2022, für den Neubau übersetzt und ergänzt. Die Beispiele zeigen den damaligen Stand und sind keine getestete Anleitung für die heutige Website. Beachte Nutzungsbedingungen, Zugriffsgrenzen und robots.txt des jeweiligen Anbieters; eine Begrenzung ist keine Aufforderung, sie zu umgehen.
Eine Schwierigkeit beim Suchen größerer Datenmengen ist eine begrenzte Trefferzahl. Hier geht es darum, mit dem Python-Paket geoiter ein geografisches Gebiet in kleinere Abfragen aufzuteilen – und anschließend zu zeigen, wie sich ein synchroner HTTP-Client asynchron einsetzen lässt.
Das Problem
Als Beispiel dient eine damalige Suche nach VW Golf in Deutschland: Die Oberfläche zeigte rund 31.333 Angebote an, ließ aber nur 20 Seiten mit je 20 Ergebnissen durchblättern.
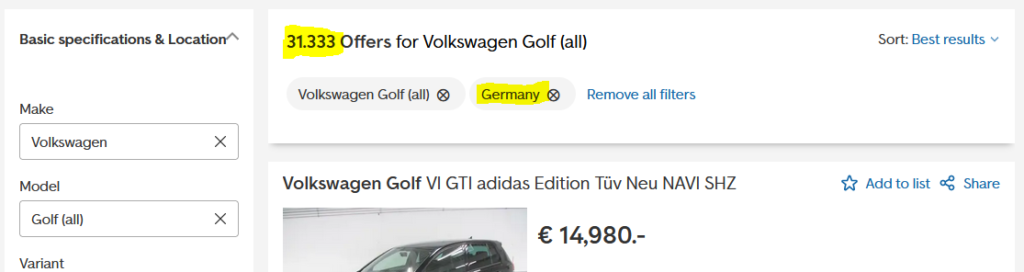

Eine größere Seitennummer direkt im URL-Parameter brachte damals keine weiteren Treffer. Ein möglicher Ansatz ist, das Gebiet in kleinere Suchbereiche aufzuteilen – vorausgesetzt, der Anbieter erlaubt diese Art der Abfrage.
Mittelpunkte mit geoiter
geoiter liefert Mittelpunkte innerhalb einer Grenze. Zunächst installieren wir das Paket:
python -m pip install geoiterMit den Beispieldaten erzeugen wir eine Liste der Mittelpunkte. Der ursprüngliche Beitrag vergaß hier die Klammern beim Aufruf von get_german_border(); das ist unten korrigiert.
# main.py
from geoiter.util.ressource_example import get_german_border
# this is a example list of coordinates. You may get you own from open street map or other geospatial services.
from geoiter import GeoIter

german_border = get_german_border()

gi = GeoIter(
    boundary=german_border,
    radius=100,
    comp_rate=20
    )

midpoints = list(gi) #  consume that iterator at once
print(len(midpoints), midpoints)

# prints:
# 18 [(54.184302636275454, 10.4540982), (54.14901311305548, 7.535786698090457), ...]
Mit einem Radius von 100 km ergab das Beispiel 18 Kreise. 30.000 Treffer geteilt durch 18 wären im Durchschnitt etwa 1.667 Treffer je Kreis – nicht 3.333. Bei höchstens 400 Treffern pro Abfrage wären bei völlig gleichmäßiger Verteilung rechnerisch mindestens 75 Abfragen nötig; reale Angebote sind aber ungleich verteilt. Ein Radius von 30 km war mein damaliger Versuch, keine Garantie für Vollständigkeit. Überlappungen erzeugen außerdem Duplikate.
Synchrones Beispiel
Das ursprüngliche Skript verwendet httpx und lxml, nimmt beispielhaft zwei Mittelpunkte und liest Suchseiten aus. Der folgende Code bleibt als historische Dokumentation erhalten. Er enthält bekannte Probleme: alte CSS-Selektoren und URL, eine unzuverlässige Seitenberechnung bei exakt durch 20 teilbaren Trefferzahlen und keine Duplikatbehandlung. Nicht ungeprüft ausführen.
# main.py
import math
import httpx  # or any other popular http client.
from lxml.html import fromstring  # or use bs4

from geoiter.util.ressource_example import get_german_border
# this is a example list of coordinates. You may get you own from open street map or other geospatial services.
from geoiter import GeoIter

german_border = get_german_border()

# we keep a reference here
query_radius = 30

gi = GeoIter(
    boundary=german_border,
    radius=query_radius,
    comp_rate=20
)

midpoints = list(gi)  # consume that iterator at once
print(len(midpoints), midpoints[:2])

base_url = r"https://www.autoscout24.com/lst/volkswagen/golf-(" \
           r"all)?sort=standard&desc=0&atype=C&ustate=N%2CU&powertype=kw "


def parse_offers(body_tree):
    # prints the results of one html page with max. 20 offers
    articles = body_tree.xpath("//article")
    for article in articles:
        title = article.xpath(".//h2/text()")[0]
        price = article.xpath(".//p/text()")[0]
        print(title, price)


def main():
    # here we limit the coordinates just for demo purposes.
    for coordinate in midpoints[100:102]:
        query_url = f"{base_url}&lon={coordinate[1]}&lat={coordinate[0]}&zipr={query_radius}"
        response = httpx.get(query_url)
        assert response.status_code == 200
        body_tree = fromstring(response.text)
        query_size = body_tree.xpath("//div[@class='ListHeader_top__jY34N']/h1/span/span/text()")[0]
        if query_size:
            parse_offers(body_tree)
            more_pages = int(query_size) // 20
            print(f"I need to scrape now {query_size} offers or {more_pages} more page(s).")

            for page in range(1, more_pages + 1):
                response = httpx.get(query_url + f"&page={page + 1}")
                body_tree = fromstring(response.text)
                parse_offers(body_tree)


if __name__ == '__main__':
    main()
Asynchrones Beispiel
Die folgende Variante nutzt httpx.AsyncClient und mehrere Tasks. Asynchron heißt nicht automatisch schneller und schon gar nicht unbegrenzt viele Anfragen: Parallelität und Wiederholungen müssen zum Server und dessen Vorgaben passen. Auch dieser historische Code ist nicht aktuell getestet und enthält zusätzlich den Fall, dass asyncio.wait() eine leere Taskmenge erhalten kann.
# main.py
import asyncio
import httpx  # or any other popular http client.
from lxml.html import fromstring  # or use bs4

from geoiter.util.ressource_example import get_german_border
# this is a example list of coordinates. You may get you own from open street map or other geospatial services.
from geoiter import GeoIter

german_border = get_german_border()

query_radius = 30

gi = GeoIter(
    boundary=german_border,
    radius=query_radius,
    comp_rate=20
)

midpoints = list(gi)  # consume that iterator at once
print(len(midpoints), midpoints[:2])

base_url = r"https://www.autoscout24.com/lst/volkswagen/golf-(" \
           r"all)?sort=standard&desc=0&atype=C&ustate=N%2CU&powertype=kw "


def parse_offers(body_tree):
    articles = body_tree.xpath("//article")
    for article in articles:
        title = article.xpath(".//h2/text()")[0]
        price = article.xpath(".//p/text()")[0]
        print(title, price)


async def fetch_page(client, query_url):
    response = await client.get(query_url)
    body_tree = fromstring(response.text)
    parse_offers(body_tree)


async def fetch_query_coro(client, query_url, loop):
    response = await client.get(query_url)
    assert response.status_code == 200
    body_tree = fromstring(response.text)
    query_size = body_tree.xpath("//div[@class='ListHeader_top__jY34N']/h1/span/span/text()")[0]
    if query_size:
        parse_offers(body_tree)
        more_pages = int(query_size) // 20
        print(f"I need to scrape now {query_size} offers or {more_pages} more page(s).")

        pending = set()
        for page in range(1, more_pages + 1):
            pending.add(
                loop.create_task(fetch_page(client, query_url + f"&page={page + 1}"))
            )
        done, pending = await asyncio.wait(pending)


async def main():
    client = httpx.AsyncClient()
    loop = asyncio.get_event_loop()
    async with client:
        pending = []
        for coordinate in midpoints[100:102]:
            query_url = f"{base_url}&lon={coordinate[1]}&lat={coordinate[0]}&zipr={query_radius}"
            pending.append(
                loop.create_task(fetch_query_coro(client, query_url, loop))
            )
        done, pending = await asyncio.wait(pending)


if __name__ == '__main__':
    asyncio.run(main(), debug=True)
Die Grundidee bleibt: geografische Teilbereiche erzeugen und Ergebnisse kontrolliert verarbeiten. Für einen tatsächlichen Einsatz zuerst eine erlaubte Schnittstelle verwenden, das Ergebnis deduplizieren, Grenzen respektieren und die Fehlerbehandlung ergänzen.